
熱門資訊> 正文
做一個能自迭代的后訓練平臺,Mind Lab要讓更多企業擁有自己的模型
2026-09-23 17:39
文|王欣逸
編輯|張雨忻
如果你近期有和投資人閒聊兩句,會得出這樣一個結論:AI圈的關注點再一次回到了模型和AI Infra(基礎設施)。模型,對應着時下應用遇冷,熱度向上遊轉移;而AI Infra的關注點之一,是后訓練平臺和推理平臺。
昨天,Mind Lab發佈了他們的最新成果:推出面向行業的模型后訓練與推理平臺Mint Recursive,以及基於這一平臺做后訓練的模型Macaron-V1.1。
Macaron-V1.1是一個基於GLM-5.3做后訓練、參數為752B的模型。 7月,Mind Lab創始人陳鍇傑告訴我們,從基於GLM-5.1后訓練的Macaron-V1-Preview到基於GLM-5.2的Macaron-V1,中間只隔了不到一個月。而迭代還在加速,據瞭解, Macaron-V1.1從上一代迭代而來僅用了不到兩周。
Macaron-V1.1由744B的基座模型和四個2B的LoRA專家模塊組成,其中四個LoRA分別負責Chat、Agent、Coding和Generative UI(生成式UI)。
從V1的1B LoRA變成了現在的2B LoRA,他們也正在摸索更為理想的專家參數規模。從Benchmark結果來看,相比V1,V1.1在6個Agent榜單上全面提升,在SWE-Marathon(超長程AI編程能力)表現尤為出色。。
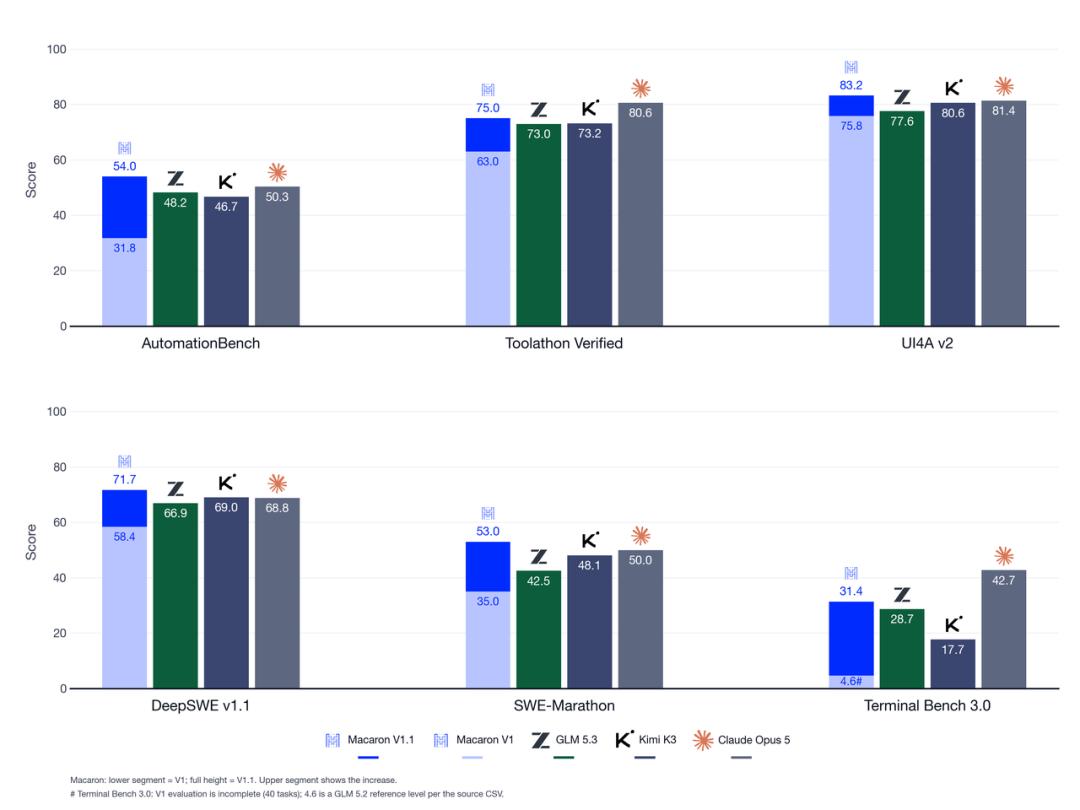
△Macaron-V1.1 benchmark表現,來源:企業
更值得注意的是,Macaron V1.1完全基於Mint Recursive完成訓練。
Mint Recursive是一個后訓練與推理平臺,其工作流程包括測評、數據、后訓練與部署推理,用户通過API和Python SDK即可調用平臺的訓練和部署能力;還能接入生產環境中的反饋,讓模型在真實任務中持續改進。而這套流程,Mint Recursive 在Macaron V1.1模型的迭代上已經跑通。
就在這一節點,Mind Lab集中發佈了一系列成果,把過去一段時間在持續學習與Infra領域積累的Know-how,沉澱為一套可對外提供的服務。
做后訓練的Infra
Mind Lab一邊做模型、一邊做Infra,這並不讓人意外。
在今年1月,他們就率先推出了Mint Recursive的早期形態——一個關於LoRA訓推的基礎設施平臺,為客户提供大模型后訓練全流程解決方案。
與此同時,在Infra層面下功夫,正慢慢成為一個行業共識。
幾天前,智譜創始人、首席科學家唐傑在X上發了一篇長文,闡述了他們用AI改進AI的最新進展,他們讓GLM-5.3驅動的Infra Agent,自動優化GLM-5.3自己的推理引擎,讓一個超10萬張國產芯片組成的集群,在不到兩周的時間里,將端到端吞吐提升至初始基線的3倍。
智譜正在做的就是讓AI去自我改進推理層Infra。同樣是模型參與優化自己,大家想解決的問題不同——Mind Lab要做一個后訓練平臺,想優化的是從整個后訓練到部署推理的流程,囊括數據、評測、部署、反饋收集等步驟。
Mint Recursive平臺由三大模塊組成:Train&Deploy(訓練與部署)、Env Hub(環境中心)、Data&Experience(數據與經驗)。這一平臺支持模型、SFT(監督微調)、RL(強化學習)、DPO(偏好訓練)、全參微調等算法,兼容GLM、Qwen、DeepSeek、Kimi、MiniMax等多種尺寸的開源模型;訓練完成后可一鍵部署,還有配套的測評體系,為下一輪模型訓練做準備。
去年9月,OpenAI前CTO Mira Murati創辦的Thinking Machines Lab發佈了一篇名為《LoRA Without Regret》的技術博客,從理論和實驗上證明了,只要方法得當,LoRA的效果可以比肩全參數微調。從那以后,LoRA幾乎成了后訓練領域的普遍採用的方案。
值得一提的是,Mind Lab一直關注「LoRA」這一后訓練範式,這次他們也在這條路線上更進一步,在Mint Recursive中,他們用LoRA把訓練和部署都做成了Serverless(無服務器)的模式:客户無需自己買GPU、管理集群,可以直接按Token用量計費。
在訓練側,Mint Recursive想實現的是讓模型更聰明——用LoRA的方式,只訓練一些少量的新增參數,根據業務目標,不斷從業務反饋中學習、持續迭代能力,讓模型變得更懂業務,與此同時,還能顯著降低企業后訓練的開銷。
在部署側,4個LoRA專家模塊對應的4個業務版本各自是一個輕量級的Adapter(外掛插件),掛在同一個基座模型上。這些Adapter互不干擾、非常靈活,每個Adapter都能單獨升級、上線與下線,歷史版本也保留着,便於客户對照與回滾。客户也可以把某個Adapter合併到基座模型里,變成一個完整的、獨立的模型。
這也正是LoRA的核心思路,共用基座模型,在每個業務場景只做針對性的后訓練。好處在於,模型后訓練、部署與迭代的成本能實現大幅下降,調整權重也更加靈活。
后訓練所需的數據、評測、反饋等,每一步都離不開Infra的支撐。從做后訓練到做后訓練Infra,Mind Lab的選擇很自然。
但在交出Mint Recursive答卷之前,他們也能做了很多準備:
2025年,Mind Lab開始在Kimi K2這樣的萬億參數模型上做后訓練研究,Mint Recursive的基礎設施最早也是那時開始搭的;
隨后,2025年底,他們向NVIDIA Megatron-Bridge貢獻了業界首個1T參數量級的LoRA-RL,為Megatron補充了面向超大規模基座的輕量化強化學習的經驗;
2026年中,參與火山引擎的強化學習訓練框架veRL、NVDIA的下一代訓練后端megatron_lite等多個開源項目,提供了一些LoRA和強化學習解決方案;
2026年7月,Macaron-V1系列正式發佈並開源,驗證了這套訓練方案在Agent、Coding等任務中的有效性。
Infra很重要,但不是所有公司都能做Infra,以及有必要單獨做Infra。
萬億模型的后訓練,工程難度遠超想象。分佈式訓練的顯存調度、訓推一致性的精度對齊、異步RL的權重熱更新,對於一家創業公司而言,每一塊都是硬骨頭。
陳鍇傑告訴我們,訓練小模型的強化學習其實很容易,但是一旦規模上來了,難度會變得非常大,尤其是他們還在強化學習之上,疊加了LoRA的持續學習訓練方法。
目前,Mint Recursive主要提供三種服務:類似FDE形式的專家與企業一起完成訓練;依託平臺進行自動化訓練;企業通過API和Python SDK自主訓練。
訓一個企業自己的模型
越來越多企業想要擁有自己的模型,這也是輕量的后訓練、持續學習的訓練範式被推崇的原因。
從落地角度看,企業端或許是定製化模型最為迫切的場景。「通用大模型僅能覆蓋各行業20%-30%的場景,剩下70%-80%的部分,都需要垂直持續學習來優化。」陳鍇傑提到。
海外市場已經先一步驗證了這個趨勢。Fireworks AI,一家做開源模型推理和后訓練託管的硅谷公司,今年7月,其估值已經達到175億美元,ARR突破10億美元,日Token處理量超過40萬億。
Fireworks AI CEO喬琳在和紅杉的對談中提到:「后訓練已經不是模型團隊專屬遊戲了,AI產品在找到PMF、開始規模化后,后訓練幾乎是它們繞不開的一門必修課。」
具體來看,相比於模型廠商,AI產品公司的壁壘在於用户真實使用產生的數據、真實任務、反饋與偏好等。Fireworks平臺上95%以上的流量,來自客户自己微調的專用模型,而不是通用基座。這一邏輯,被喬琳定義為「擁有自己的智能」。
「應用公司做模型」這一選擇,正發生在越來越多的企業身上—— AI應用的競爭點從產品本身,逐漸變成產品的經驗智能,包括自己的判斷、Taste、業務數據和對客户的理解等方面。
應用公司最獨特的資產來自真實生產環境:它知道用户究竟想完成什麼、哪些結果算好、哪里反覆失敗,以及專業人員真正怎樣判斷結果。如何讓企業擁有自己的智能、把行業經驗合併進基座模型中?
Mint Recursive在嘗試的就是 讓企業建立起自己的評測體系、獎勵機制、訓練數據,把后訓練做成一個持續迭代的閉環 :模型在服務用户后積累下真實任務場景數據,每次交互的軌跡,無論成功還是失敗,都會被完整記錄下來。
這其中,失敗的軌跡相當有價值,哪里做錯了、為什麼錯、應該怎麼改,平臺在找到問題和解決方法后,這些判斷和軌跡會直接變成新的訓練數據;用新數據重新訓練完上線后,又會產生新的反饋,新的反饋又變成下一輪訓練的輸入,如此循環往復。
平臺中的Env Hub(環境)環節容易被忽略,但它尤其關鍵。英偉達的一篇Agentic RL技術博客中提到,做Agent強化學習需要環境來定義數據集、驗證器和狀態。環境不只是模型的訓練場,也是評測場,評測、合成數據、強化學習,都可以在一套環境中完成。
儘管Mint Recursive中的Recursive(遞歸)還處於初級形態——人依然在遞歸的迴路中,離模型全自動自己訓練還比較遙遠,但模型迭代方向已經很明確了。對客户而言,更為重要的不是模型本身,而是企業手里的一線業務現場與獨一無二的真實業務數據。
圖片來源|企業供圖
歡迎關注~
歡迎交流~
本文來自微信公眾號「智能涌現」,作者:王欣逸,36氪經授權發佈。


