熱門資訊> 正文
20年過去了,主數據為什麼還這麼火
2026-07-14 09:42
一家年營收數百億的製造企業,主數據系統里存了42萬條供應商記錄,數據準確率超過98%。從KPI看,這是一個漂亮的成績單。
可去年,一家供應商突然暴雷,導致產線停工三天,直接損失超過兩千萬。
事后覆盤發現:這家供應商的資質文件、工商信息、歷史交易記錄全都在系統里,合規、完整、沒有明顯錯誤。
問題出在哪里?
數據是對的,但系統不知道這些數據意味着什麼。它把風險信號靜靜地躺在那里,等有人來查——可沒有人來查。
這就是主數據管理(MDM)20多年來一直被討論的原因:它解決了一半的問題,另一半始終懸在那里。
而今天,AI正在把那另一半接上。
一、20年四幕戲:從"兼職管"到"AI鍛造"
主數據管理不是新概念。如果從上世紀90年代算起,它已經走了30年。如果從21世紀初概念正式成型算起,也有20多年了。
這20年,可以分成四幕戲。
第一幕:ERP兼職管(1990s—2000s初)
90年代,企業開始大規模上ERP。SAP、Oracle帶着物料主數據、客户主數據、供應商主數據的模塊走進企業。
那時候的問題很簡單:一個系統內,數據要統一。
ERP自帶的主數據模塊,兼職管管夠用了。反正企業就那麼幾個系統,數據在ERP里維護好,大家從ERP取數,天下太平。
但好日子沒過多久。
第二幕:多系統混戰(2000s中—2010s初)
CRM來了,SCM來了,MES來了,PLM來了,財務共享來了。一家大型集團突然發現自己在運行十幾個甚至幾十個業務系統。
同一個供應商,在採購系統里叫"上海XX科技有限公司",在財務系統里叫"XX科技(上海)",在CRM里只留了個縮寫。税號版本不一致,聯繫人三套,銀行賬户還有兩個歷史版本混在里面。
沒有人知道哪個是對的。
這不是極端案例。這是絕大多數中型以上企業數字化轉型深入到一定程度后,必然碰到的同一堵牆。
數據亂了,而且越亂越快。
ERP自帶的模塊只能管本系統,跨系統打通能力為零。數據倉庫解決的是分析層問題,管不了主數據的全生命周期。人工加Excel?數據量小還能應付,規模一大,錯誤呈指數級增長。
第三幕:專業MDM崛起(2010s—2020s初)
2010年后,需求催生了獨立的主數據管理系統。SAP MDG、Informatica MDM、IBM InfoSphere MDM先后進入中國市場,國產廠商如億信華辰、三維天地、數通暢聯也快速跟進。
這一階段,MDM的核心使命是建立企業級的"單一可信數據源"(Single Source of Truth)——讓每個業務系統調用的都是同一份被驗證過的數據,從根上切斷數據混亂的源頭。
建模、清洗、重複記錄合併、質量檢測、版本管理、發佈與同步——一套完整的全生命周期管理體系逐漸成型。
到2020年前后,大量大型集團完成了主數據系統的建設,基本實現了"黃金記錄"的目標。數據終於有了一個統一、準確、完整的版本。
但問題也正是在"基本完成"之后,才悄然浮出水面。
第四幕:AI重塑(2020s—現在)
2026年4月,石化盈科發佈工業物料主數據治理智能產品——盈碼AI。該產品採用石化盈科自主研發的國內工業物料領域專屬大模型,構建「智能體+大模型+高質量數據集」三位一體認知中樞,覆蓋物料全生命周期管理,提供智能創建、智能清洗、智能審覈、智能檢索、知識問答五大開箱即用的智能應用。
盈碼AI可實現主數據運營人工成本降低60%以上、效率提高80%以上、單人單日物料代碼處理量增加4倍以上,大幅釋放企業內部生產力,全面賦能ERP、MES、SRM等核心業務系統,打通設計、採購、製造、維保等全鏈條,全面重塑新型工業化引擎。
2026年7月,三維天地發佈AI原生的智乾主數據管理平臺V14(MDM GenAI),從七個核心環節重新定義了MDM的底層邏輯。
這不是一次功能疊加,而是一次範式躍遷。
我用一張表概括這次躍遷:
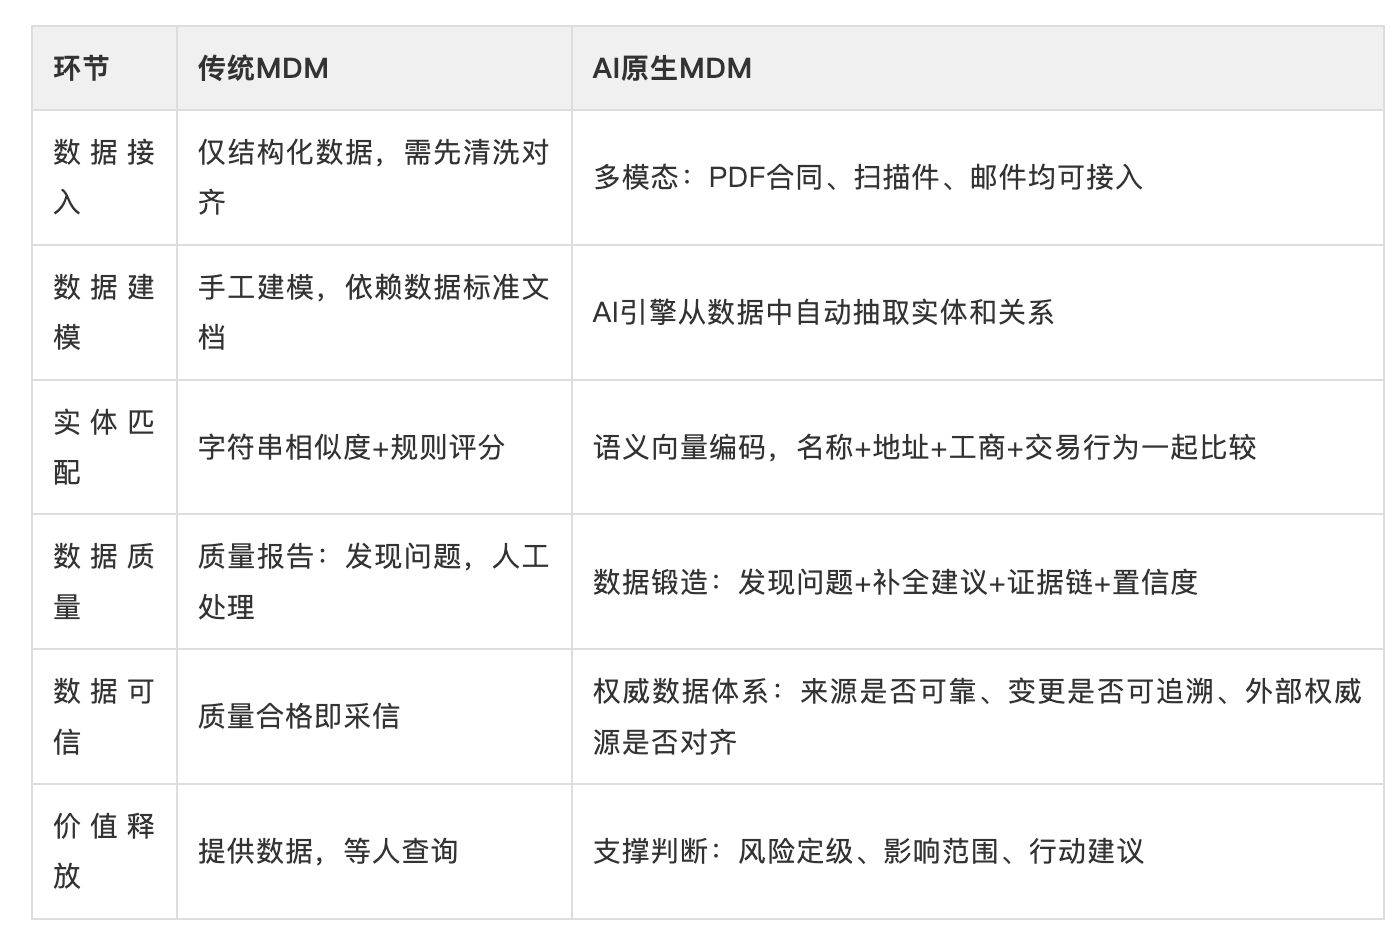
前四個變化,解決的是高質量主數據怎麼建起來;后兩個變化,把主數據從"被動記錄"推向"主動決策"。
從"黃金記錄"到"智慧決策"——這是主數據管理下一個二十年的方向。
二、為什麼20年了還這麼火?三個結構性原因
很多人會問:一個搞了20年的東西,為什麼還在被反覆討論?為什麼市場還在快速增長?
因為需求不是在縮小,而是在擴大。三個結構性原因:
原因一:系統越來越多,數據越來越亂
20年前,一家企業可能只有ERP和財務系統兩個核心系統。今天呢?ERP、CRM、SCM、MES、PLM、WMS、OA、財務共享、BI、數據中臺、AI平臺……大型集團動輒幾十個甚至上百個系統並存。
系統越多,數據孤島越多,主數據混亂的面積就越大。這不是管理不善導致的偶發問題,而是多系統並存時代的結構性矛盾。
只要企業還在增加新系統——雲原生、微服務、SaaS化只會讓系統更多——主數據管理的需求就不會消失,反而會持續放大。
原因二:數據要素市場化,主數據成了"資產身份證"
2026年,數據資產入表政策深化實施,DCMM 2.0國標7月1日正式生效,數據產權登記有了操作指引。
主數據是什麼?它是客户、供應商、物料、組織、人員、產品這些核心業務對象的唯一權威標識——換句話説,它是企業數據資產的"身份證"和"身份根目錄"。
數據要入表,你得先搞清楚你有哪些數據資產。數據資產要估值,你得先確保數據的準確性和一致性。數據要流通交易,你得先有可被驗證的標準化數據源。
這一切的起點,都是主數據。
沒有乾淨的主數據,數據資產入表就是一筆糊塗賬。沒有標準化的主數據,數據產權登記就沒有可登記的"標的物"。
原因三:AI要可信,主數據是"地基"
這是最新也是最強的一個驅動力。
大模型要產生可信的推理結果,必須建立在單一、準確的主數據源之上。如果AI從一個充滿重複、矛盾、過時數據的"數據沼澤"里取數,那它的輸出一定是垃圾進、垃圾出。
MDM正在從"后臺數據管理工具"升級為"企業AI戰略的底層推動者"。
反過來,AI也在重塑MDM本身:
傳統MDM靠人工規則配置做實體匹配,AI用語義向量自動識別"聖約翰醫院"和"St. John's Hospital"是同一實體
傳統MDM出質量報告等人處理,AI直接給補全建議和置信度
傳統MDM需要數據管理員專業技能,AI讓業務人員用自然語言就能查詢和管理主數據
傳統MDM只能處理結構化數據,AI原生MDM連PDF合同、掃描件、郵件都能自動抽取實體和屬性
需求在擴大,技術在升級,政策在推動——三重合力,主數據管理想不火都難。
三、市場數據説話:MDM是增長最快的軟件賽道之一
直覺歸直覺,數據歸數據。來看看市場到底有多火:
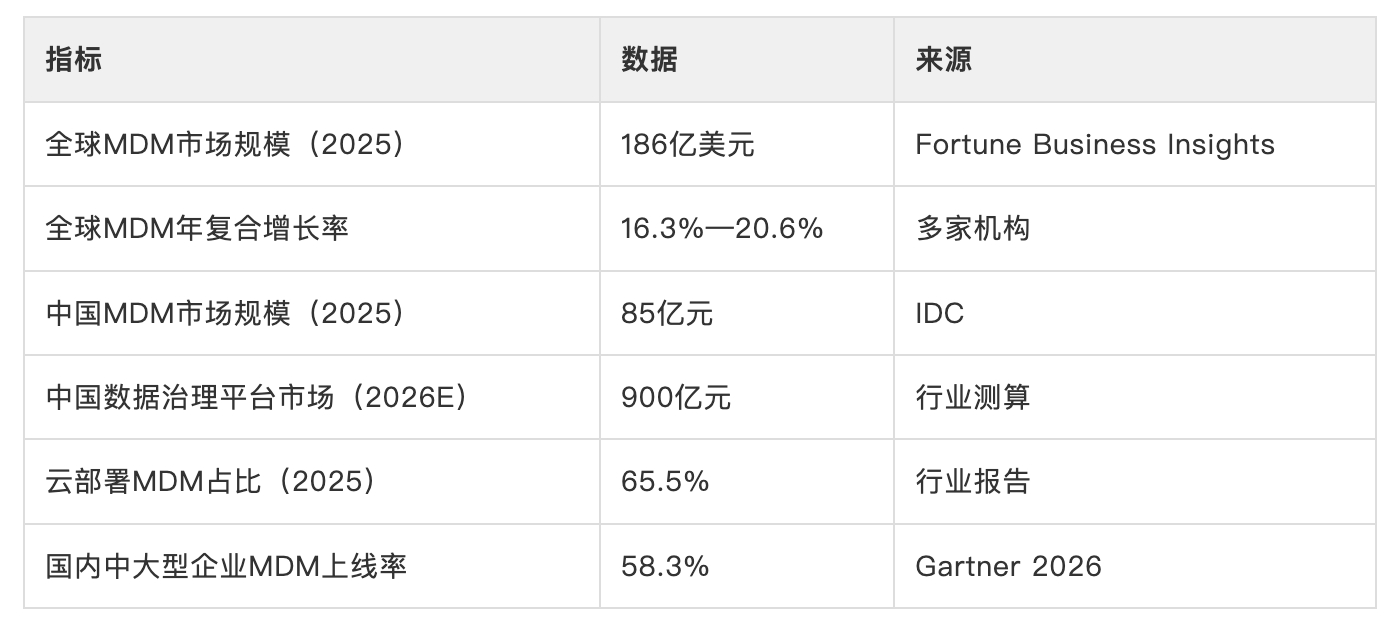
幾個關鍵信號:
第一,增速遠超企業軟件平均水準。全球企業軟件市場年均增速大約7-8%,MDM的16%以上增速是平均水平的兩倍多。這意味着主數據管理不是在隨大盤增長,而是在加速滲透。
第二,雲化部署成為絕對主流。65.5%的雲部署佔比意味着MDM正在從"重實施、長周期"的定製化項目,轉向"開箱即用、快速迭代"的SaaS模式。中小企業導入門檻大幅降低。
第三,國內滲透率仍有巨大空間。58.3%的中大型企業上線率看似不低,但意味着還有超過四成的中大型企業尚未建設專業MDM。加上中小企業幾乎空白,增量市場非常可觀。
第四,亞太是全球增速最快的區域。中國和印度的數字化進程是核心驅動,亞太地區增速領跑全球。
一個賽道能火20年還保持16%以上的增速,在企業軟件領域極為罕見。這本身就說明了主數據管理的剛需屬性——它不是可選項,而是基礎設施。
四、國產化浪潮:中國企業的四重約束
如果説全球MDM市場是一盤大棋,那中國市場就是其中最特殊的一局。
對於中國企業,尤其是央企、金融、政務、醫療等關鍵行業,MDM選型不只是技術選擇,而是四重約束下的戰略決策:
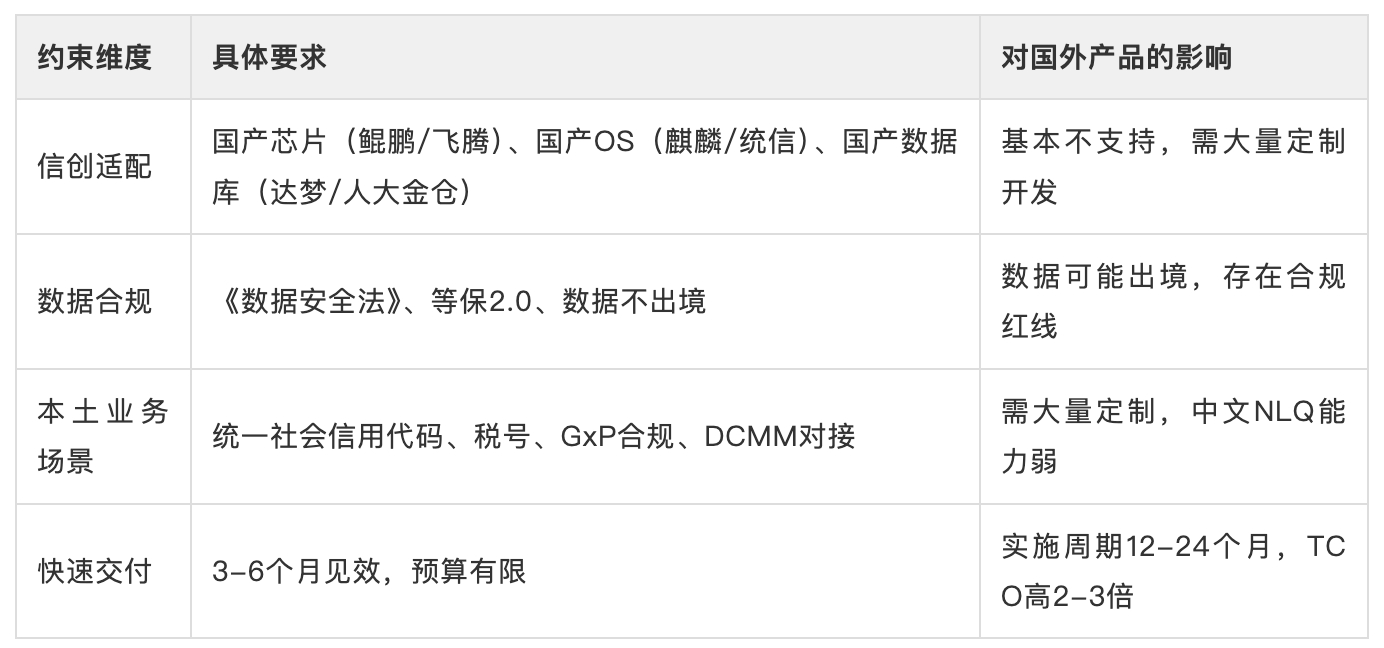
這四重約束不是軟性的"偏好",而是硬性的"入場券"。
數據顯示,國產MDM廠商的市場份額正在持續攀升,信創生態適配已經從"可選項"變成了"入場條件"。億信華辰連續四年位居中國數據治理解決方案市場份額第一,被Gartner列為數據資產管理、數據治理及數據編織技術代表廠商。三維天地從2002年推出自主MDM平臺,二十余年迭代到AI原生的V14。
這不是情懷驅動的國產替代,而是約束驅動的必然選擇。
當然,客觀來説,在全球化多語言支持、超大規模跨國企業場景、與國際主流雲平臺的生態集成上,國際頭部產品仍有積累優勢。對於跨國運營、深度綁定Salesforce/Workday生態的企業,國外產品可能是更優選擇。
但對於絕大多數中國企業來説,方向已經基本鎖定。
五、從"黃金記錄"到"智慧決策":MDM的下半場
回到開頭那個案例。
42萬條供應商記錄,準確率98%,可一家供應商暴雷就損失了兩千萬。數據是"對的",但系統沒有"理解"這些數據。
傳統MDM被設計成一個"記錄系統"——把數據管準、管全、管一致,就算完成任務。至於這些數據意味着什麼、正在釋放什麼信號、下一步該提醒誰、推動誰行動,傳統架構並沒有真正覆蓋。
這就是主數據管理20年來始終"還差一口氣"的根本原因。
而AI原生架構正在補上這一口氣。具體體現在三個層面:
層面一:從"質量合格"到"權威可信"
數據質量的合格不代表數據內容的可信。一個字段可以不為空、格式正確,但如果來源從未被驗證,它仍然不應該被無條件採信。
AI原生MDM引入"權威數據體系"——追蹤每個數據來源是否可靠、變更是否可追溯、外部權威源是否持續對齊。不是"格式對了就行",而是"來源可信纔算數"。
層面二:從"提供數據"到"支撐判斷"
一份高度可信、完整可追溯的黃金記錄,如果只是放在那里等人查詢,價值仍然是潛在的。
AI原生MDM在主數據標準模型之上建立一層領域知識模型(本體論),讓系統獲得推理的基礎。系統不再只是"提供數據",而是理解變化背后的業務含義,把這種理解轉成面向不同角色的行動建議。
業務團隊收到的,不再只是"請審覈"的主數據申請工單,而是一份已經帶有風險定級、影響範圍、證據鏈和建議動作的決策簡報。
層面三:從"專家工具"到"全員參與"
傳統MDM是"少數專家的工作"——需要數據管理員配置規則、編寫腳本、執行清洗。
AI原生MDM讓自然語言接口成為可能。業務人員不需要技術知識,直接問系統"查一下華東區所有A類供應商的最近一次審覈時間",就能得到實時準確的答案。
數據治理從"IT部門的工程"變成"全員參與的實踐"。
這三個層面的變化,讓主數據管理的價值釋放路徑從"數據管準→業務可用"延伸到了"數據可信→主動決策→價值創造"。
六、給企業的四條行動建議
聊了這麼多,落到實操層面,企業該怎麼做?四條建議:
第一條:從一個域開始,別貪多。
MDM項目失敗的原因,十有八九不是技術問題,而是範圍過大、推進過慢、業務參與度低。優先從數據混亂最突出、業務影響最大的域入手(通常是客户或供應商),在3-6個月內跑通一個完整的治理閉環。
第一個域能不能跑通,基本決定整個項目的命運。跑通了,后續推廣順水推舟;跑不通,整個項目大概率擱置。
第二條:業務部門必須參與,不能只是IT項目。
主數據的定義、審批流程、數據標準,需要業務主管作為"數據Owner"深度參與。如果上線后沒人維護,數據很快又會亂回去。
第三條:關注AI能力路線圖,而非只看當前功能。
選型時不要只看今天的產品功能列表,要問廠商三個問題:你們在AI實體匹配上的準確率是多少?你們的NLQ支持哪些中文業務場景?你們的AI能力是自研的還是貼牌的?
AI能力不是"有就行",而是"能不能真正用起來"。
第四條:評估三年TCO,別隻看軟件報價。
軟件許可費、實施服務費、二次開發費、年度維保費、擴容費用——全部加起來算三年總賬。很多項目初始報價看着不高,三年下來翻了兩三倍。要求廠商提供包含所有費用的三年TCO方案,而非只看軟件報價。
最后的話
主數據管理為什麼20多年了還這麼火?
因為企業系統的數量在增長,數據混亂的面積在擴大,數據要素市場化需要標準化的資產身份證,AI大模型需要可信的數據底座。
因為需求不是在縮小,而是在結構性放大。
20年前,主數據管理的使命是建立"黃金記錄"——把數據管準、管全、管一致。
20年后的今天,AI正在把使命推向下一段——從"黃金記錄"走向"智慧決策",從被動記錄走向主動判斷,從IT后臺走向業務前臺。
主數據管理的終點,不是數據整潔。
而是讓每一個業務決策,都能站在可信數據的肩膀上。
*本文數據來源:Fortune Business Insights、Gartner、IDC、Coherent Market Insights等機構公開報告,及行業公開資料。文中案例為行業典型場景綜合整理。
本文來自微信公眾號「數據驅動智能」(ID:Data_0101),作者:王建峰,36氪經授權發佈。
推薦文章
華盛早報 | 香港首份五年規劃+26年施政報告今日公佈!加密貨幣《清晰法案》遭否;OpenAI再融資:估值已達1.2萬億美元

網安股成AI交易新主線?Crowdstrike、派拓網絡年內升逾100%!還有哪些標的值得關注?
華盛早報 | AI「減速論」攪動美股!費半指數重挫近6%,網安股逆勢飆漲;十年美債收益率近三年來首破5%;華爾街警告加息恐致標普500重挫10%
港股異動 | AI板塊全線低開!南方兩倍做多海力士跌逾13%,建滔積層板跌近4%,長飛光纖光纜、中際旭創跌逾3%
華盛早報 | AI利空突襲?科技三巨頭支持放緩AI研究;機構稱美聯儲年內或連續加息三次;智譜融資50億美元全力押注RSI領域
港股周報 | 逆勢掃貨?北水周內爆買港股逾200億港元;光通信迎多重利好!劍橋科技升逾24%;DeepSeek降價衝擊AI大模型股
一周財經日曆 | 美聯儲利率決議重磅來襲!沃什將如何表態?香港將公佈首個五年規劃;美國證交會將討論24小時交易事宜
美股前瞻 | 8月CPI符合預期,美聯儲下周加息概率拉昇至90%;油價重挫逾3%,伊朗與海灣六國下周會晤;SpaceX再籤天價算力單,績優股甲骨文盤前漲逾7%


