热门资讯> 正文
AI洪流三部曲续:碳基价值捕获与硅基价值创造
2026-10-10 14:02
对于AI模型商而言,捕获率决定了未来的潜在收入水平;对于AI使用者而言,价值创造率决定了AI带给企业的降本增效水平。 前者对应着短期的市场景气度和硬件侧的交易空间,而后者则对应着更长期的数据中心回报率和模型收入能力。
在此前的《AI洪流三部曲》中,我们尝试给出了AI技术所影响的劳动力规模以及对应的薪资水平;但在理解潜在收入上限时依然缺少关键一环,即AI技术的增效水平,进而量化潜在可代替的支出水平。
除此之外,行业视角下AI对人类薪资池的捕获率高低也越发关键,尤其是当AI收入焦点从单一的Coding转向科研(AI4S)、办公场景、文娱传媒等更广泛领域。
AI的薪资捕获率与价值创造率实际上是站在不同视角看待技术发展:对于模型商而言,薪资捕获率决定着未来的潜在收入水平;对于使用AI的企业而言,价值创造率决定着AI在纯替代视角下能享受的降本增效水平。
前者对应着短期的市场景气度和硬件侧的交易空间,而后者则对应着更长期的数据中心回报率和模型收入能力。
尤其是最近的Muse应用可能采用“抽成”的商业模式(类似瓦特改良蒸汽机的收入来自于节约煤炭价值的三分之一),可以理解为在当前这个Agent模态下进行技术改良,这也更加说明理解“AI效率提升”的重要性。
我们根据Anthropic的公开数据,重新构造了美国全量职业视角下的AI维度,补充了职业/行业视角下AI的增效倍率、AI技术所创造的价值分布以及不同行业的薪资捕获率水平——这三个关键计算结果。
由于数据有限,以及统计口径的原因,在部分指标估算中存在较大偏离,在第四部分我们将进行充分讨论。
一、不同行业的捕获率差异巨大,计算机行业不到10%,金融行业不到2%
计算即时捕获率,以及不同行业潜在空间的计算方法并不复杂:只需要用ARR收入乘不同行业使用率作为行业实际收入贡献,将结果与实际暴露度下对应的薪资总数对比,即可得到行业视角下捕获率的近似描述。
然而,该方法的难点在于Token消耗量的行业分布数据(以及对应价格)难以挖掘;我们只能找到Anthropic公布的“以任务次数调用”统计的使用率数据。
这意味着一次计算机行业任务与餐饮服务业任务调用含有相等权重,但现实情况是计算机行业单次任务消耗的Token或是其他行业的数十倍。由于这种有偏对应(只能用“调用次数”而不是“消耗token数”来代表AI收入),导致部分行业(例如金融业)的捕获率可能偏低。
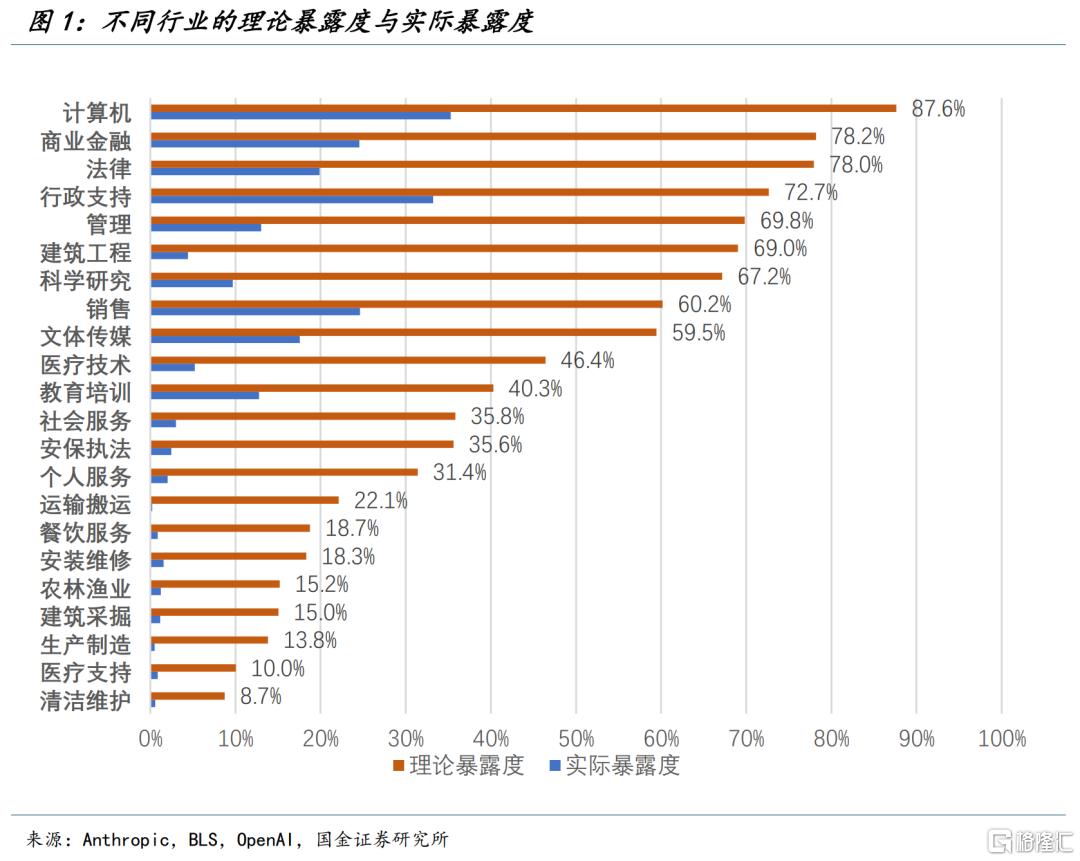
首先,我们“再次”展示截止到2026年3月(最后的数据更新月份),行业视角下的实际技术暴露度与理论技术暴露度水平。理论上最有可能被AI替代的行业是计算机与数学(87.6%)、商业与金融(78.2%)以及法律(78.0%),但实际观察到的暴露度排序与理论值并不一致,实际暴露度最高的行业是计算机与数学(35.3%)、办公室与行政支持(33.2%)以及销售相关职位(24.6%)。
对于这个暴露度数值,我们再次强调这并不能理解为有35%的员工已经失业,或者有35%的任务已经可以AI自动化,而应该理解为“将每一个职业拆解成不同的任务后,以完成每个任务的时间加权的情况下,有35%的任务已经在Anthropic的AI使用中被观察到”。
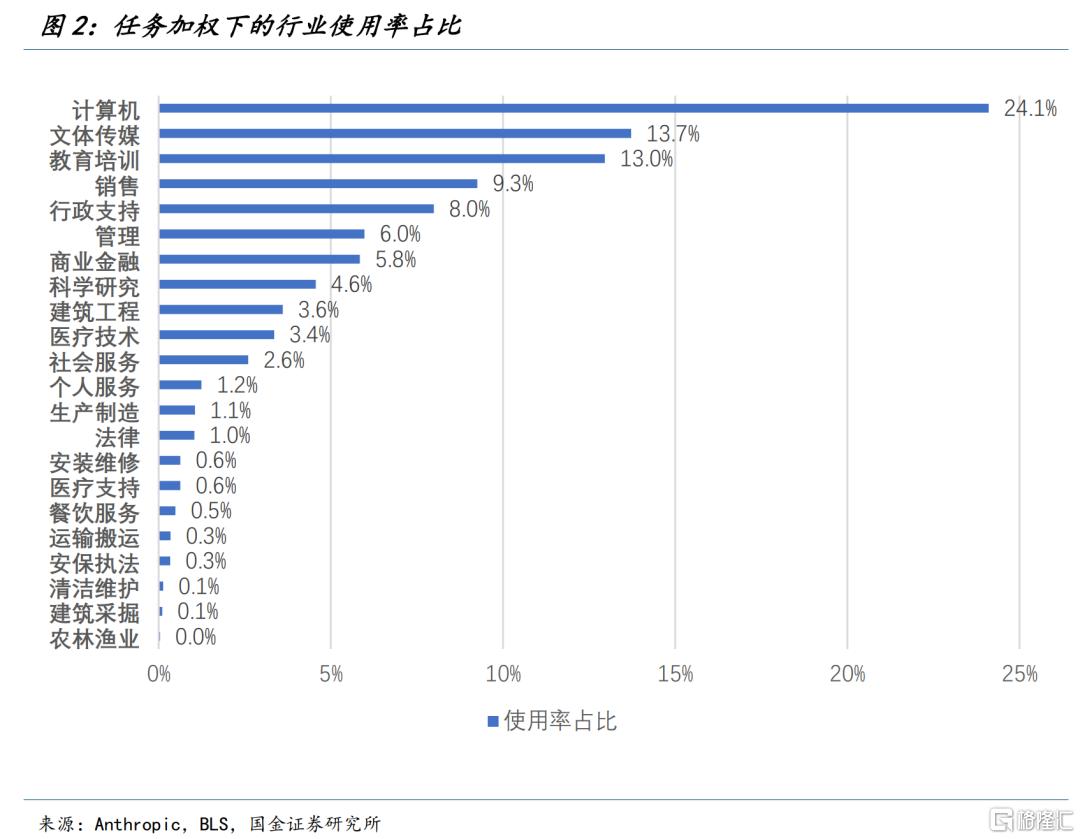
接着,我们展示以任务次数为权重的统计方式下,美国不同行业的AI使用率占比:计算机行业占据了约25%的使用次数(尽管仍被严重低估),文体传媒业接近15%,而金融行业仅占5%——单次任务越复杂,环节越多,调用的Token也会越多,而金融业采用AI的任务更多以“大篇幅”为主,占比自然较低。
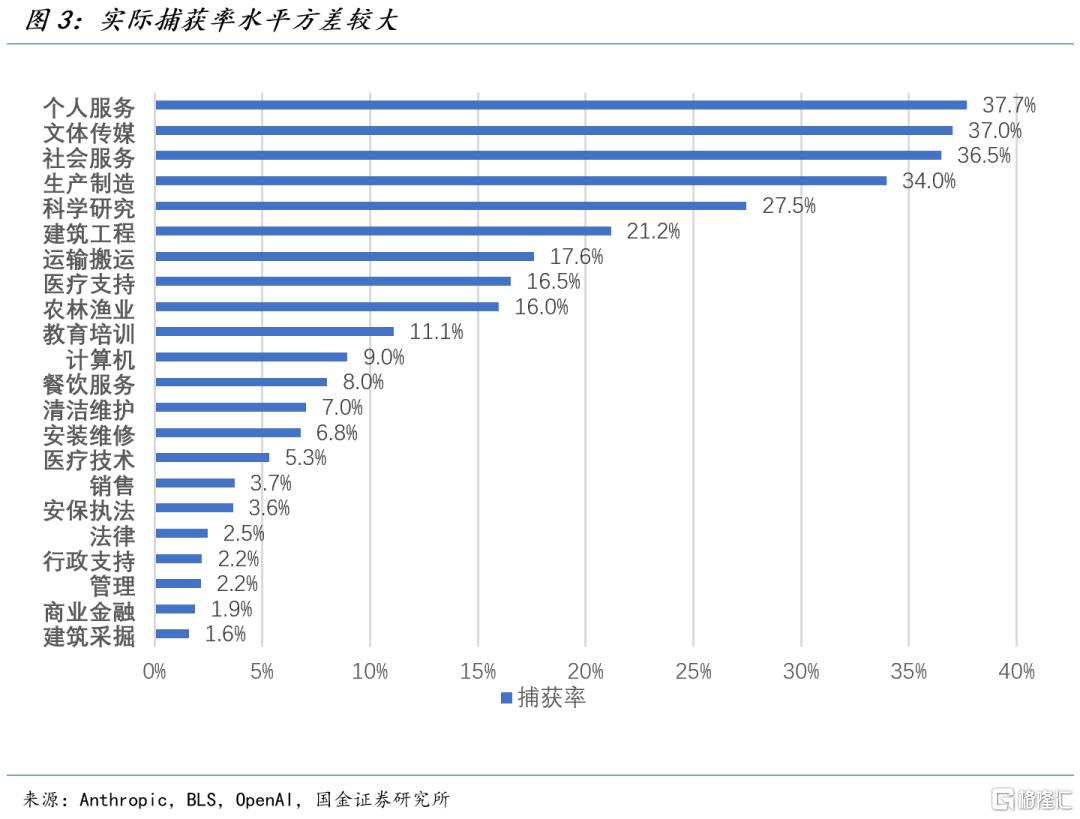
基于以上数据,我们对于捕获率水平进行直接的计算:因为数据本身只更新至5月,我们假设AI大模型的总ARR收入在800亿美元水平,得到了捕获率的结果如下:计算机行业的捕获率大约在9%,而金融行业的捕获率仅在1.9%。
我们可以从数学计算的角度找到一个“解释”(但并非完全合理):金融行业的分子过小,即使用率水平低;但分母过大,24.5%的实际暴露度水平对应着约2500亿美元的总薪资水平。
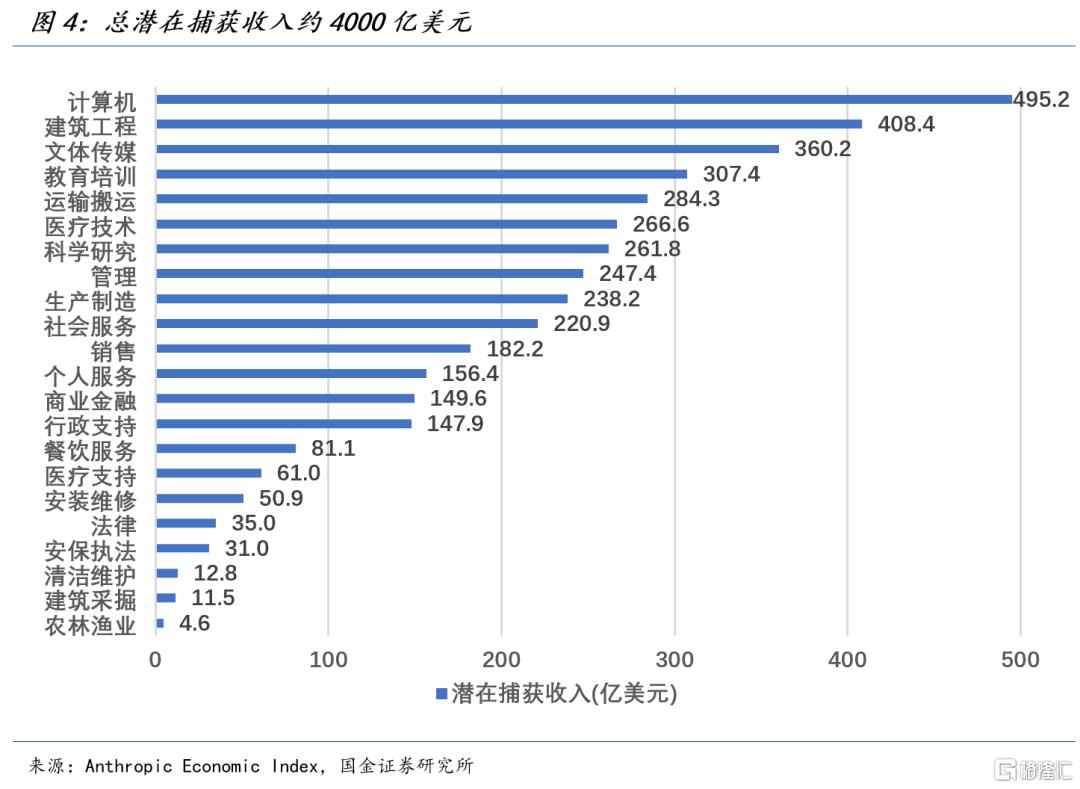
最后,我们也可以对未来潜在捕获收入进行一个估计,即用当前不同行业的捕捉水平去对标未来理论暴露薪资收入。在这个纯替代视角下,潜在捕获收入在4000亿美元水平,其中计算机行业贡献500亿美元,建筑工程和文体传媒位居第二和第三位,分别为410和360亿美元。
就整体数值和行业排序来看,基本符合产业发展逻辑。一方面,4000亿美元基本是替代视角下ARR收入的某种边界共识。另一方面,除了计算机外,建筑工程(辅助设计)与运输搬运(自动驾驶、运力规划)的收入贡献排名靠前,与AI的流程优化有关;而文体传媒与教培行业则体现出了AI的“定制能力”。
二、AI平均增效约7倍,计算机行业享受约四分之一的“价值创造”
接下来,我们换到AI使用者的视角,讨论对于那些使用AI的企业/职业/任务,技术本身带来了多大的效率提升。如果Meta公布的Muse真的要采用抽成而非订阅模式,这会成为未来理解Agent发展的新关键。
这里我们从“消费者剩余”的角度来理解接下来要展示的数据——当使用者付给模型商的水平恒定之后,AI创造的额外价值即为AI技术带给消费者的“消费者剩余”。
根据Anthropic公布的全量数据,我们得到了美国755个职业(部分空缺)对应的每次使用AI完成任务的平均时间,同时Anthropic也公布了反事实估计值,即如果这个任务由人类自主完成,所需要的平均时间。基于这两个数据,我们可以得到初步的AI增效倍率,再根据每一个职业的使用占比和对应的时薪水平,我们可以得到应用AI技术后,行业视角下的价值创造分布情况。
我们通过举例方式进行简要说明:电脑程序员(行业名称:Computer Programmer,职业编号:15-1251),使用AI情况下平均任务时间为52.35分钟,不使用AI完成时间(估计值)为9.12小时,即547.2分钟——AI的增效倍率则为547.2/52.35 = 10.45。在对每一个职业进行类似统计后,以使用占比作为权重加权可以得到行业视角下的增效倍率。
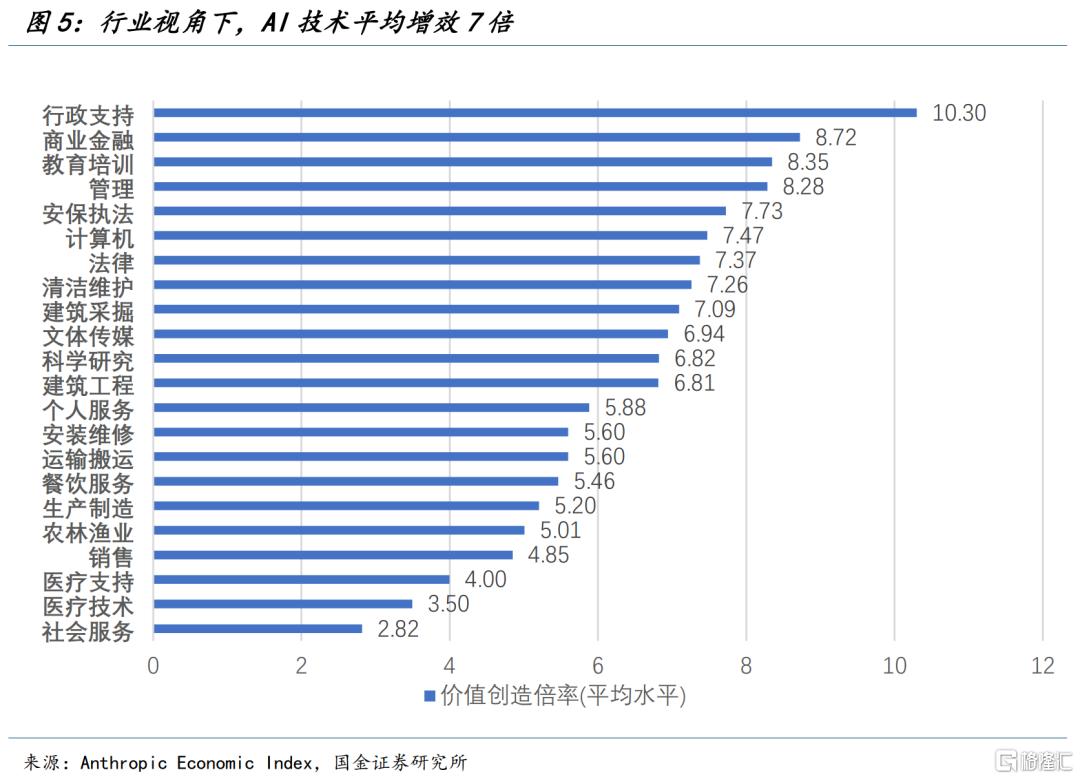
自下而上的计算整合后,我们观察到使用AI技术平均增效7倍,增效最明显的是行政支持行业,约10.3倍,最低的是社会服务和医疗,仅2.8倍。计算机行业大约在7.2倍,而金融行业在22个行业增效倍率排名第二,高达8.7倍。
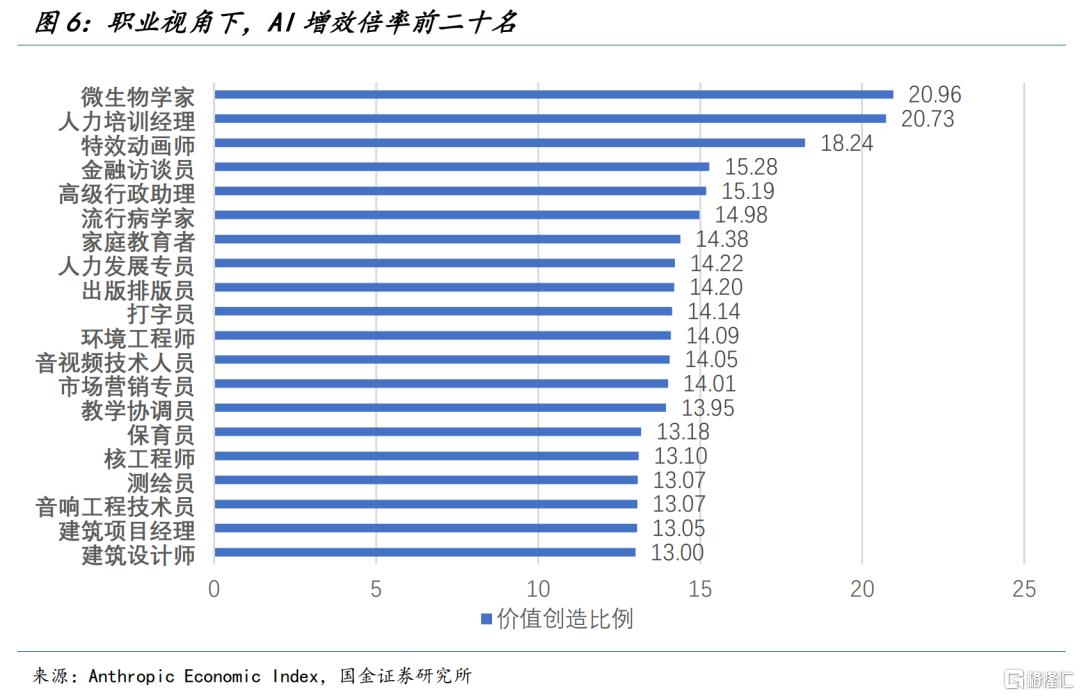
从职业视角来看(排除使用率为0的职业),AI带来的效率提升最明显的职业是微生物学家(20.96倍),前20当中包括了前沿科学领域,行政支持领域以及艺术行业。这也比较符合当前对AI发展方向的期待,科研是AI技术一个新的扩展领域,尤其是对于大量可重复,有方法论的研究来说,AI的降本增效更加明显——近期数学界千禧年问题的持续突破,以及数百个前沿问题的集中解决是一个很好的例证。
三、AI的价值创造与“消费者剩余”
有了每个职业的增效水平,以及AI使用率占比后,我们可以计算职业/行业视角下的AI价值创造分布。依然以计算机程序员为例进行说明,已知其使用AI情况下平均任务时间为52.35分钟,不使用AI完成时间(估计值)为9.12小时,即547.2分钟,因此使用AI节约了494.85分钟(8.25小时),则可以粗略的理解为AI单次任务的价值创造为8.25小时乘以时薪。
问题在于,我们只知道使用率分布,不知道具体调用次数,因此无法知道每一个职业/行业具体的价值创造水平,但可以算出价值创造的分布——即每个行业分了“多少比例”的AI价值创造蛋糕,但是不知道这个蛋糕“有多大”。
对于价值创造具体数值(V)缺乏更多数据计算,因而我们着重关注单一职业的价值创造比例(Share)。在计算中,N作为总次数会被约分,使用率、时间以及每个职业对应的时薪此前已举例说明:
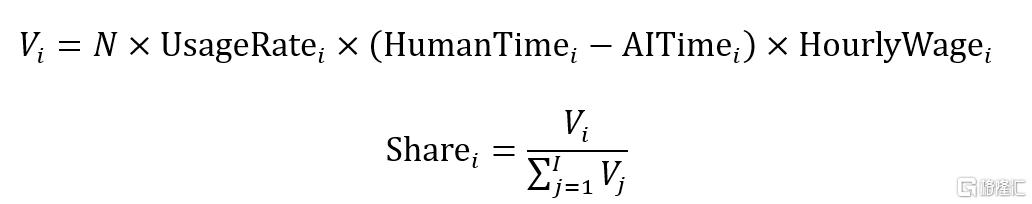
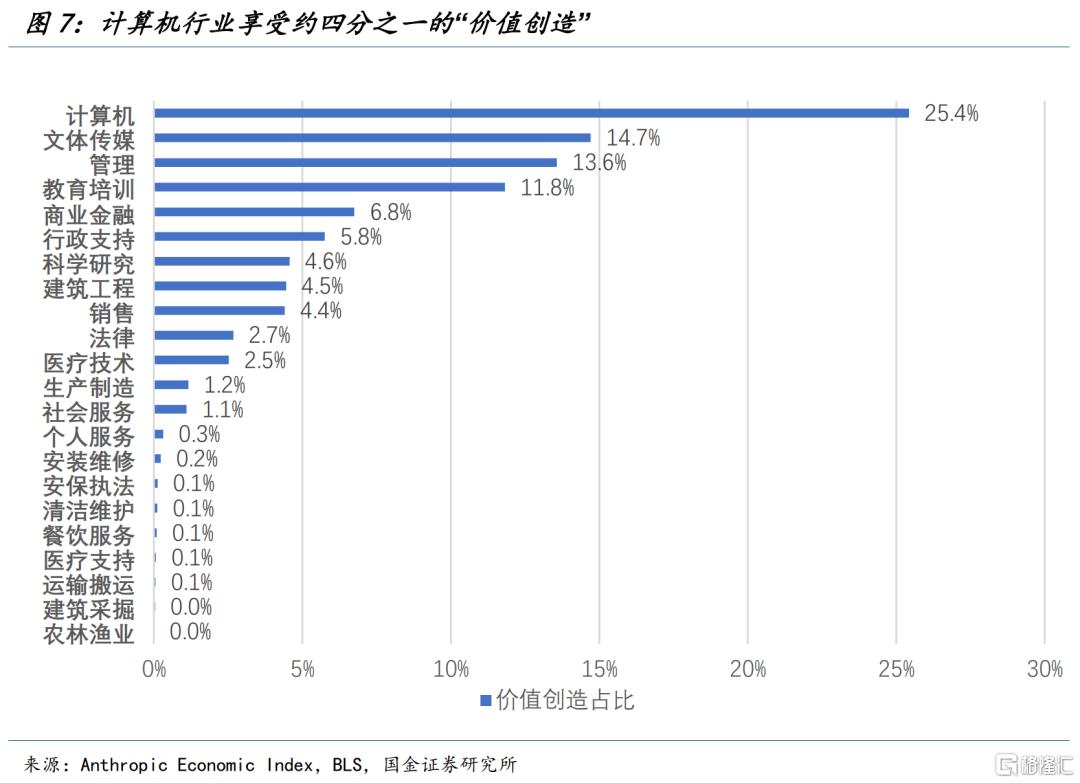
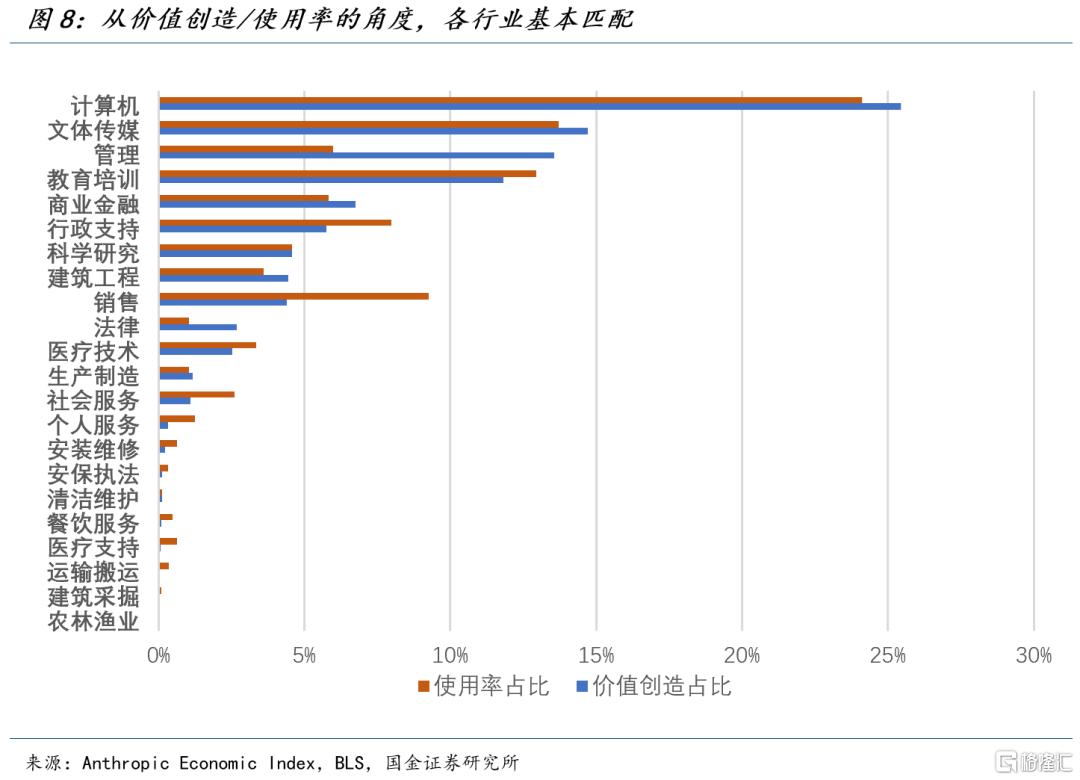
经过计算,计算机行业获得了AI价值创造(消费者剩余)的25%,文体传媒行业也获得了AI价值创造的近15%,管理、教育培训也都是使用AI的主要受益者。AI价值创造的行业排序也符合AI交易的热点方向:比如Coding的场景应用之后,近期火热的AI短剧行业体现了AI在文体传媒行业中的价值创造,培训行业(包括教培、人力资源培训等)也可以通过AI进行更加个性化/定制化的服务。
有了以上数据后,我们可以把行业的使用率与价值创造率进行对比,进而勾勒出AI使用的“性价比水平”,即是否价值创造率高的行业使用较多。
总的来说,两者基本匹配,这意味着AI价值创造倍率高的行业也基本对应更多的AI技术使用。但其中出现了两个相对例外,一个是管理行业,用约5.9%的任务次数创造了约13.6%的“消费者剩余”,这主要依赖该行业的高附加值属性;另一个是销售行业,用了约9.3%的任务次数,只创造了4.4%的额外价值。
当然,我们强调这些估计都是以“消费者剩余”的视角,最终这些价值以什么样方式转化(是增加劳动者的休闲时间,还是增加资本家的投资回报),依然存在较大不确定性。
我们再次强调的是,因为缺少总调用次数,无法直接计算这些消费者剩余的绝对规模,这是个较为遗憾的地方。
这里我们引用一些前沿论文的估算进行交叉对比:Brynjolfsson等人的2026年4月论文测算(What is Generative AI Worth):站在2025年末的节点,全球生成式AI的收入约142亿美元,对应的美国消费者剩余约1162亿美元,即倍率约为1162/142 = 8.2倍(假设绝大多数都发生在美国);这与Anthropic估算的约7倍的AI技术平均增效水平较为接近。
当然两者的视角并不一致,Brynjolfsson等人的论文主要是基于AI收入,而我们则通过节约时间与薪资倒推;但大致的消费者剩余规模可能就在5-10倍的量级水平。
总的来说,目前AI创造的大部分消费福利仍由用户而非厂商获得,AI已经创造了很大的隐性价值,但产业收入和利润对这些价值的捕获仍明显滞后——但是如果AI不可避免地从硬件交易转向关注软件,这个“价格创造倍率(消费者剩余)”视角将更加重要。
四、以上估算所存在的弊端,以及未来观察视角
我们最后单独讨论捕获率视角与价值创造视角估算所存在的弊端,这并不只因为某些估计中呈现出了极大的方差水平,更是希望引发对未来观察AI收入水平尺度的一些思考。
正如前文所反复强调的那样,我们的核心估计主要依赖于任务次数的分布,而非Token消耗量,天然低估了一些高收入创造能力行业(比如计算机、金融等)的占比,进而低估了AI技术的潜在捕获率。
还有对捕获率的恒定假设(外推到理论总薪资),也限制了替代型AI技术的潜在收入空间——因为随着模型能力的快速增长,以及技术自然渗透的S曲线,捕获率会随着时间推移而逐渐上升。
再深一层的思考,薪资是衡量替代型AI技术潜在收入的度量尺度,但创造型AI技术已经出现,同时过去普遍担忧的广泛裁员似乎并未发生,那么是否有衡量AI未来收入的更好尺度?随着时间的推移,这个问题可能需要重新审视。
其次是技术暴露度的度量意义或被高估,Agent进入到第四个季度,美国信息技术业的裁员依然缓慢。根本问题是观察到任务被暴露,并不等于AI能自主完全执行任务,因此暴露度高估了工资池范围(实际薪资暴露),进而低估了捕获率水平(薪资作为分母被高估)。
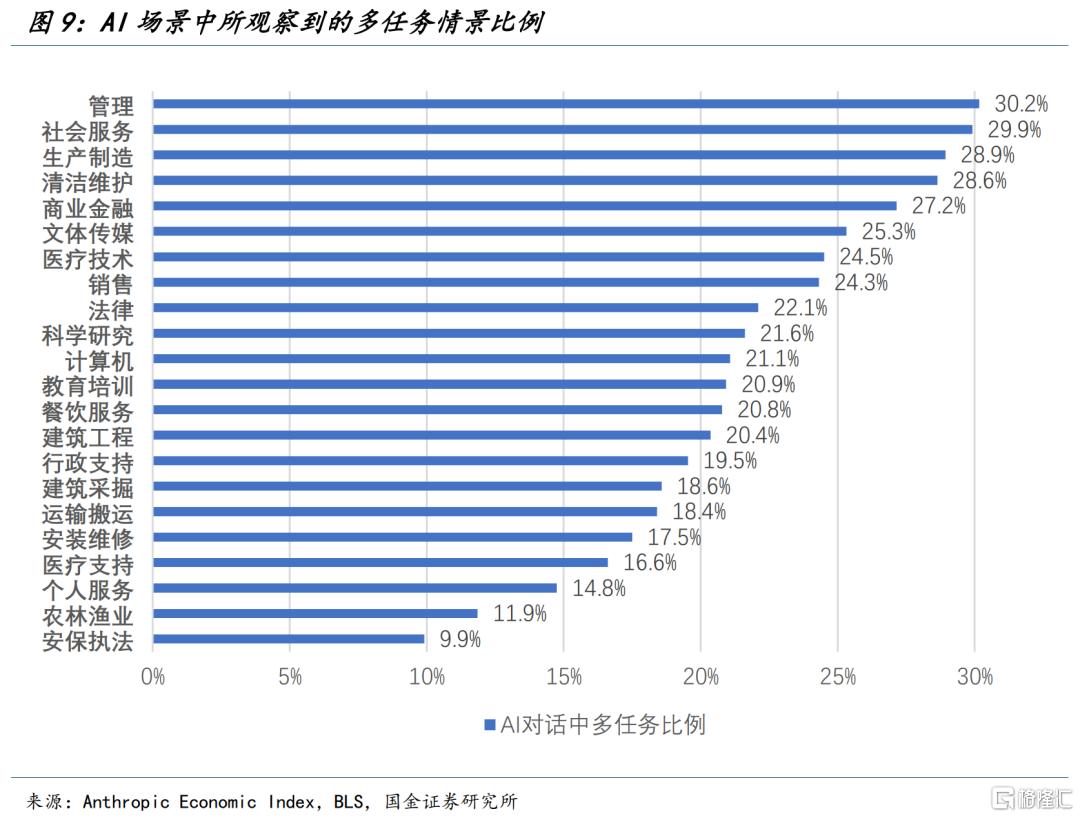
另一个高估技术暴露度的因素来自于当前更多职业都具备多任务属性(multi-task);当前社会的主要工作岗位都对应着多个任务,因此在职业主任务中AI带来的效率提升/技术暴露并不能完全等效于整个职业对AI技术的反馈。
且大多数岗位都存在多任务串联的特性,即任务链条存在前置条件;这些都意味着从技术到效率再到就业与收入的影响并非按比例传导,而是有所损耗,进而高估AI技术能力。
我们理解,在数据允许的情况下,未来有三个非常重要的观察视角。
首先是价值创造水平,因为当前AI产业自证需要的是可量化的收入,但是大量的福利通过消费者剩余的方式被AI使用者所享受,如何定量这些水平,而非简单盯住ARR和硬件订单,会成为从硬件交易向软件/应用过渡的重要参考。
其次是薪资水平的参考尺度,尽管在短期尺度AI在大多数行业依然是替代型技术,但是现代社会的多任务属性决定着劳动力薪资或许并不是当前AI收入的主要来源,换言之对于AI的劳动力冲击可以相对乐观一些。
最后是研究方法的缺乏,如果AI真的用以创造,那BLS视角下的755个职业,以及背后对应的数千个任务属性是否能够准确描述AI在当前社会正在做什么?如果越来越多的任务被划归为“无法定义”,如果AI成为一个多模态,多任务并行处理的工具,我们讨论的就不仅仅是某个职业或者某个行业。
金融、计算机、文娱传媒与前沿科学研究完全可以在某个时间被AI所融合,这或许才是未来软件应用所追求的方向:上限不是单一行业的单一薪资,而是全社会的总价值创造能力。另一个角度看,这也意味着数学家,程序员,设计师与金融分析师等各行各业劳动力共享着类似程度的职业脆弱性。
风险提示
AI技术数据更新频率较低,无法及时反馈模型能力的大幅提升;美国产业政策受党派影响明显,执政党派的更换可能引发产业政策回溯;AI技术发展与产业投资存在较大不确定性。
注:本文为国金证券2026年10月9日研究报告《AI双视角:行业捕获率与价值创造率》,证券分析师:宋雪涛SAC执业编号:S1130525030001、钟天SAC执业编号:S1130526020001
推荐文章
华盛早报 | 美联储纪要偏鹰!年内或再加息一次;段永平"卖put"逆势布局腾讯;恒科成分股将扩容至50只

美股前瞻 | 龙头订单排到2029年!光通信股盘前集体爆发,Lumentum劲升逾6%;新产品销量遇冷,苹果盘前走弱;瑞银喊话黄金“回调即买入”
丘盛一筹 | 别被盘面骗了!OpenAI收入谣言作祟,AI板块、半导体纯属错杀?
华盛早报 | OpenAI营收被爆200亿美元预期差!AI板块遭重创;特朗普中期选举前对伊挂“免战牌”,SpaceX收购低频段频谱,美运营商夜盘暴跌
10月9日外盘头条:特朗普称中期选举前不会攻击伊朗 苹果将举行智能家居新品发布会 OpenAI年化营收500亿美元
英伟达、甲骨文、CoreWeave及其他AI股票因OpenAI营收报告下跌
美股前瞻 | 特朗普威胁中期选举前再袭伊!国际油价大升4%,三大期指齐跌;投行喊出美光3000美元目标价;华尔街知名多头公布五大首选股
资金复盘 | 北水加仓腾讯逾24亿港元!友邦保险、小米集团-W同获抢筹


